МПС · STM32F103C8 · контрольная в пятницу, 23 октября
Контрольная 1 по МПС
Разбор двух вариантов задачи из слива и прошлогодней КР, навыки из списка «повторить» с тренажёрами, планы ответов на экзаменационные вопросы 1–13. Каждое число ведёт на страницу RM0008, PM0056 или слайд лекции. Нажми на подчёркнутую ссылку, и страница оригинала откроется слева. Синяя метка c у имени регистра показывает его адрес и имя в Си.
Прошлые конспекты (откроются в новой вкладке)
00Что известно о КР
По фото из чата (8 штук) и прошлогодней КР (7 фото, в папке Контрольная/) картина такая:
- Формат: тест в LMS, судя по таймеру, около полутора часов. В шапке теста даны ссылки на RM0008 и PM0056, значит, документацию можно открыть прямо на КР. Поэтому полезно знать, на какой странице что лежит (глава 06).
- Теоретический вопрос пишется текстом, 10 баллов. В сливе попался «Сегментное логическое адресное пространство», это экзаменационные вопросы 6–7. Готовый образец ответа в главе 05.
- Задача бывает двух видов. Вариант А: дан код, разобрать (режимы линий, приоритеты, порядок цветов, значение переменной). Это тот же самый код, что и в прошлом году, у прошлогодников даже сохранился разбор преподавателя. Вариант Б: написать три функции (RCC, GPIO, EXTI+NVIC) под условие.
Строки как в Logic Analyzer Keil: 0x1F — входы PA0–PA4 одной шиной, >5, >6, >7 — PA5 (B), PA6 (G), PA7 (R), val — переменная. Max Time 10.13914 s, Grid 0.5 s, курсор на 6.515599 s. Узкие провалы — глитчи. Полоса с именами обработчиков внизу — моя разметка, на фото её нет.
Порядок срабатывания прерываний - 4 2 3 4 1
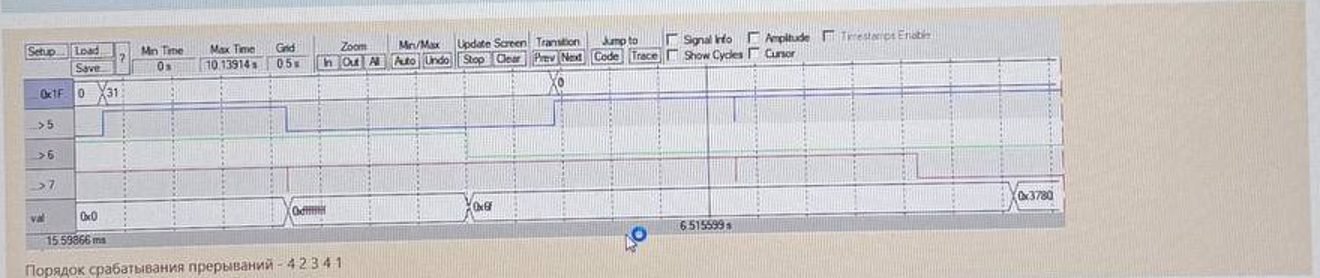
val значения 0x0 → 0xffffffff → 0x6f → 0x3780. Ниже я вывожу этот ответ из кода по шагам, и он совпадает полностью. Совпадает и время: задержка в каждом обработчике около 1,88 с. EXTI3 начал работу на 4,02 с, на 4,92 с его вытеснили (отработано 0,90 с), а оставшиеся ≈0,98 с он доделал после EXTI1 (8,64 с) и закончил на ≈9,6 с. Ровно в этот момент val становится 0x3780. Значит, вытеснение EXTI3 видно прямо на диаграмме.Сначала реши задачу сам на бумаге, потом сверься. В задаче Б решение спрятано под спойлер. На КР попадётся код с другими числами, поэтому важен способ, а не готовые ответы. Для тренировки на новых числах есть генератор вариантов задачи А и тренажёры в главе 04.
01Прерывания STM32: от ножки до обработчика
В списке «повторить» это первый пункт, и обе задачи КР построены на нём. Прерывание от кнопки проходит через два разных блока. EXTI — контроллер внешних прерываний, часть микроконтроллера ST, описан в RM0008, глава 10. NVIC — контроллер прерываний внутри ядра Cortex-M3, описан в PM0056, глава 4. EXTI превращает фронт на ножке в запрос, NVIC решает, когда этот запрос обслужить. Ниже весь путь по шагам, на примере кнопки на PA3.
Подробно, с калькулятором и стендом, тот же путь разобран в конспекте ЛР2: ЛР2 EXTI ЛР2 NVIC ЛР2 нумерация ЛР2 вход ЛР2 возврат
- EXTIНожка → линия EXTI.
AFIO_EXTICRЛиний EXTI 16 (0–15), линия n слушает ножку с номером n одного порта: PA3, PB3, PC3… Какого именно порта, задают 4 бита в
AFIO_EXTICR1…4:0000— порт A,0001— порт B (). Отсюда ограничение:Нельзя вызвать дав прерывания с одинаковым номером линии порта.
() (опечатка «дав» в оригинале). Регистры AFIO работают только при включённомAFIOEN(). После сброса везде 0000, то есть порт A, поэтому в задаче А AFIO можно было не трогать. ЛР2 стрелочник AFIO - EXTIДетектор фронта.
EXTI_RTSR,EXTI_FTSRБит n в RTSR ловит передний фронт (0→1) на линии n, в FTSR задний (1→0), оба бита — оба фронта (). Уровень сам по себе прерывания не даёт, нужен именно перепад. Поэтому линия, подтянутая к 1, не реагирует на кнопку, которая тоже подаёт 1.
- EXTIФлаг запроса.
EXTI_PR, маскаEXTI_IMRWhen the selected edge occurs on the external interrupt line, an interrupt request is generated. The pending bit corresponding to the interrupt line is also set.
() Запрос уходит в NVIC, только если в IMR стоит 1 (). Бит PR снимается записью единицы (), запись нуля ничего не делает. - NVICНомер IRQ и разрешение.
NVIC_ISERЛинии 0–4 имеют свои IRQ 6–10. Линии 5–9 делят один IRQ 23 (
EXTI9_5), линии 10–15 — IRQ 40 (EXTI15_10) (). Запрос в NVIC становится ожидающим (pending). Обслужен он будет, только если его бит стоит вISER:A interrupt can enter pending state even it is disabled.
() А если такое ожидающее прерывание потом разрешить, оно сразу и выполнится (). - NVICПриоритет.
NVIC_IPR,SCB_AIRCR.PRIGROUPБайт IPR, значимы биты [7:4]. PRIGROUP делит их на группу и субприоритет. Меньше число — выше приоритет. Три правила (): вытеснить работающий обработчик может только запрос из группы с меньшим номером; из ждущих первым идёт меньшая группа, затем меньший субприоритет, затем меньший номер IRQ; порядок нажатия кнопок роли не играет. Подробный разбор в задаче А, вопрос 2, проверка своих чисел в декодере.
- ядроВход в обработчик. стек, вектор, LR
Ядро само кладёт в стек 8 слов: R0–R3, R12, адрес возврата, PSR, LR (). Параллельно оно читает из таблицы векторов адрес обработчика: адрес вектора = номер исключения × 4 (). У IRQ n номер исключения 16 + n, поэтому у EXTI0 (IRQ 6) вектор лежит по адресу 22 × 4 =
0x58, как и в таблице (). В LR записывается особое значение EXC_RETURN, а состояние прерывания меняется с ожидающего на активное (). - кодОбработчик.
EXTI3_IRQHandlerФункция находится по имени. В таблице векторов startup-файла (
startup_stm32f10x_md.sиз пакета Keil) стоитDCD EXTI3_IRQHandler, а само имя объявлено как[WEAK]и ведёт вDefault_Handler, то есть в бесконечный циклB .. Если ошибиться в имени функции, программа молча зависнет в этом цикле. Первым делом обработчик снимает свой флаг:EXTI->PR = EXTI_PR_PR3;. - ядроВыход. EXC_RETURN, tail-chaining
Обычный
BX LRзагружает EXC_RETURN в PC, и ядро понимает, что обработчик закончился (). Если в этот момент ждёт запрос, приоритетнее того, к чему предстоит вернуться, ядро сразу переходит в его обработчик, не восстанавливая стек (tail-chaining). Если приоритетный запрос пришёл ещё во время сохранения стека, ядро сразу уходит в него (late-arriving) ().
Почему флаг PR надо снимать, и именно в начале
На схеме EXTI выход в NVIC идёт прямо из регистра PR (): запрос держится, пока стоит бит, то есть это сигнал по уровню. Что тогда происходит при выходе из обработчика: For a level-sensitive interrupt, if the signal is not deasserted before the processor returns from the ISR, the interrupt becomes pending again, and the processor must execute its ISR again.
()
- Не снять PR вообще — обработчик будет вызываться снова и снова,
mainбольше не получит управления. - Снять PR последней командой перед выходом — ты сам видел это в ЛР2: на плате обработчик срабатывал дважды, а в симуляторе нет. Запись идёт через шину в периферию, и сигнал может ещё держаться в тот момент, когда NVIC проверяет его при выходе. объяснение задержки — не из документации Поэтому PR снимают в начале обработчика, как в коде задачи А, или после записи читают PR обратно. ЛР2 подводные камни
- Не писать
EXTI->PR |= EXTI_PR_PR3.|=сначала читает регистр, а в нём стоят единицы всех ждущих линий, и записывает их обратно. Запись 1 снимает флаг, значит, так сбрасываются и чужие запросы. Только=.
Общие обработчики EXTI9_5 и EXTI15_10
Твой вариант 8 как раз с ними: PB5 → EXTI9_5, PA10 → EXTI15_10. ЛР2 PB5 и PA10
Линии 5–9 приходят в один EXTI9_5_IRQHandler. Внутри надо проверить по PR, какая линия сработала, и снять именно её флаг: if (EXTI->PR & EXTI_PR_PR7) { EXTI->PR = EXTI_PR_PR7; … }. Приоритет у всех линий 5–9 общий, раз и IRQ один: развести их по приоритетам нельзя. В задаче Б на EXTI9_5 включена одна линия 7, так что проблемы нет.
Два места в коде на Си, о которых спрашивают
volatile. Пустой циклwhile(cnt--);ничего не меняет в памяти, и оптимизатор вправе его выбросить, тогда задержки не будет.volatileзапрещает компилятору выкидывать и кэшировать в регистре чтения и записи такой переменной. По той же причинеvolatileнужен у переменных, которые меняет обработчик, а читаетmain(какval). правило языка Си Си типы и volatile#define SEC_DELAY 0x1000000;с точкой с запятой. Макрос подставляется текстом, и строка превращается вcnt0 = 0x1000000;;. Лишняя;здесь безвредна (пустой оператор), но в выражении вродеx = SEC_DELAY * 2;была бы ошибка компиляции.
Проверь себя
Сначала ответь сам, потом открой. Ещё вопросы — в главе конспекта ЛР2, написанной как раз к этой контрольной: ЛР2 задачи и вопросы к контрольной
?Две кнопки на PA3 и PB3, обе нужны с прерываниями. Получится?
Нет. Обе ножки сидят на линии EXTI3, а AFIO_EXTICR1 выбирает для линии один порт (). Одну из кнопок придётся перенести на ножку с другим номером.
?У двух прерываний одинаковые группа и субприоритет, кнопки нажали почти одновременно. Кто первый?
Меньший номер IRQ, независимо от того, какую кнопку нажали раньше. Если же одно уже выполняется, второе ждёт его конца: одинаковая группа не вытесняет (). Этот вопрос задавали на защите ЛР2, и «по порядку нажатия» засчитали как неверный.
?Выполняется обработчик с группой 2, субприоритет 3. Пришёл запрос с группой 2, субприоритет 0. Вытеснит?
Нет. Вытеснение решает только группа (). Субприоритет 0 лишь поставит его первым в очередь на момент, когда текущий закончится.
?В IPR записали 0x0F, а в другой IPR 0x00. Какое приоритетнее?
Они равны. Биты [3:0] не хранятся, оба значения превращаются в 0x00 (). Дальше решит номер IRQ.
?Фронт пришёл, когда бит в ISER был 0. Через секунду ISER включили. Что будет?
Прерывание выполнится сразу после включения. Запрос всё это время висел как ожидающий: и в EXTI_PR, и в NVIC (). Поэтому перед включением ISER полезно снять старые флаги в EXTI->PR, как в решении задачи Б.
?По какому адресу лежит вектор EXTI4?
IRQ 10, номер исключения 16 + 10 = 26, адрес 26 × 4 = 104 = 0x68. Сверка: .
?Во время задержки внутри EXTI4 снова пришёл фронт на линии 4. Что будет?
Бит PR4 встанет снова, NVIC пометит EXTI4 ожидающим. Вытеснить сам себя он не может (та же группа), поэтому сразу после выхода EXTI4 выполнится ещё раз (). Такое бывает в сгенерированных вариантах задачи А: порядок вида «4 4 …».
02Задача А: проанализировать код
У микроконтроллеру подключены кнопка и RGB светодиод с общим катодом по следующей схеме:
Проанализируйте код и развернуто ответьте на следующие вопросы:
- В какой режим настраиваются каждая из линий порта А микроконтроллера?
- Какое прерывание наиболее приоритетное?
- В каком порядке будут меняться цвета светодиода если нажать кнопку и отпустить ее после переключения на красный цвет(только красный, не сочетания красного с другим). Считать, что дребезгом и отличием времени распространения сигнала по линиям можно пренебречь. Не учитывать глитчи (короткие зажигания светодиода, которые отменяются без временной задержки)
- Чему будет равно значение переменной val после завершения работы всех обработчиков прерываний.
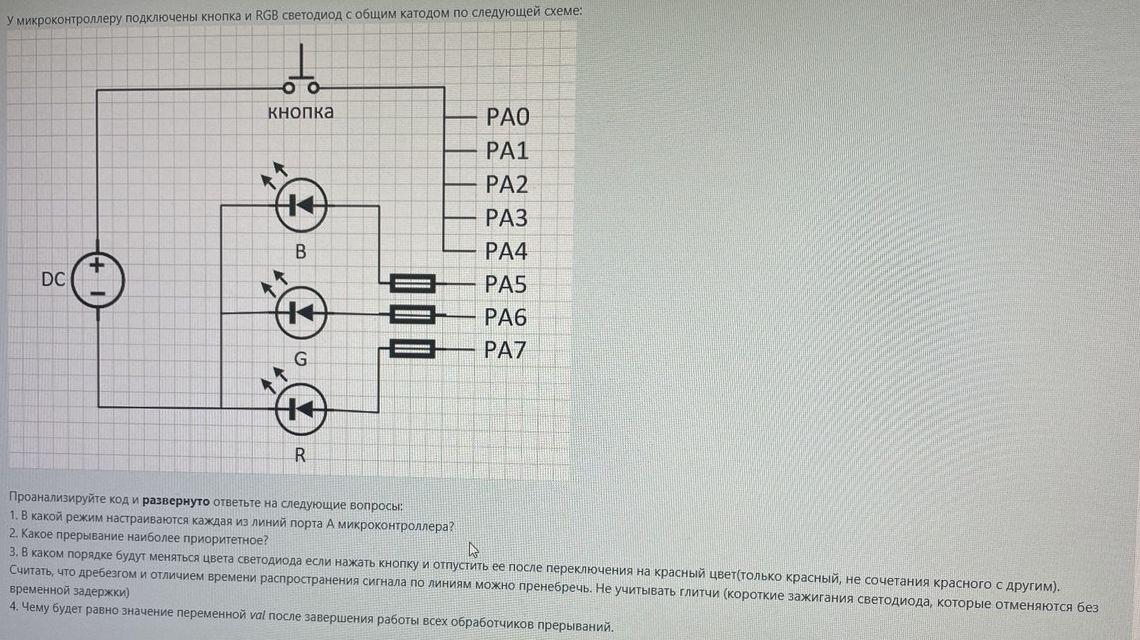
Код с фото, дословно. Номера строк нужны для пошагового прогона ниже: текущая строка там подсвечивается.
#include "stm32f10x.h"#define SEC_DELAY 0x1000000; void EXTI0_IRQHandler(void);void EXTI1_IRQHandler(void);void EXTI2_IRQHandler(void);void EXTI3_IRQHandler(void);void EXTI4_IRQHandler(void); volatile uint32_t val = 0;volatile uint32_t cnt = 0; void EXTI0_IRQHandler(void){ volatile uint32_t cnt0 = SEC_DELAY; EXTI->PR = EXTI_PR_PR0; GPIOA->ODR ^= 0xE0; while(cnt0--); GPIOA->ODR &= 0xBF; val ^= 0x111;}void EXTI1_IRQHandler(void){ volatile uint32_t cnt1 = SEC_DELAY; EXTI->PR = EXTI_PR_PR1; GPIOA->ODR ^= 0xA0; while(cnt1--); GPIOA->ODR &= 0x7F; val |= 0111;}void EXTI2_IRQHandler(void){ volatile uint32_t cnt2 = SEC_DELAY; EXTI->PR = EXTI_PR_PR2; GPIOA->ODR ^= 0x80; while(cnt2--); GPIOA->ODR &= 0xDF; val &= 111;}void EXTI3_IRQHandler(void){ volatile uint32_t cnt3 = SEC_DELAY; EXTI->PR = EXTI_PR_PR3; GPIOA->ODR ^= 0x40; while(cnt3--); GPIOA->ODR &= 0x3F; val <<= 0b111;} void EXTI4_IRQHandler(void){ volatile uint32_t cnt4 = SEC_DELAY; EXTI->PR = EXTI_PR_PR4; GPIOA->ODR ^= 0x20; while(cnt4--); GPIOA->ODR &= 0x5F; val |= ~val>>val;} int main(void){ RCC->APB2ENR |=RCC_APB2ENR_IOPAEN; GPIOA->CRL = 0x22288880; GPIOA->ODR = 0x000000C8; SCB->AIRCR = 0x05FA0400; NVIC->IPR[EXTI0_IRQn] = 44; NVIC->IPR[EXTI1_IRQn] = 99; NVIC->IPR[EXTI2_IRQn] = 171; NVIC->IPR[EXTI3_IRQn] = 163; NVIC->IPR[EXTI4_IRQn] = 9; EXTI->FTSR = 023; EXTI->RTSR = 035; EXTI->IMR = 037; NVIC->ISER[0] = 0x0780; for(;;) cnt ++; return 0;}
- Системы счисления литералов.
023,035,037,0111с ведущим нулём записаны в восьмеричной системе.111без префикса десятичное.0b111двоичное, это 7.0x111шестнадцатеричное. Таблица в главе 04. - IPR хранит только старшие 4 бита. IPR — байт приоритета прерывания в NVIC. Из 44, 99, 171, 163, 9 значат только биты [7:4], младшая тетрада пропадает (, разбор в вопросе 2).
- Номер IRQ ≠ номер линии EXTI. ISER — регистр NVIC, где бит n разрешает прерывание с номером IRQ n ().
ISER[0] = 0x0780включает IRQ 7–10. По таблице векторов () это EXTI1–EXTI4, а EXTI0 (IRQ 6) не включён. - PA0 в аналоговом режиме читается как 0, фронтов на нём нет (, вопрос 1).
- Задержка внутри обработчика. Пока идёт
while(cntN--), прерывание из более приоритетной группы может его вытеснить (). Это меняет и цвета, и итоговоеval. volatileу счётчиков и;в#define. Безvolatileоптимизатор выбросил бы пустой цикл задержки, а лишняя точка с запятой здесь безвредна. Подробно в главе 01.- Сдвиг на число ≥ 32 в
~val>>valдаёт 0 на Cortex-M3 (, вопрос 4).
Вопрос 1. В какой режим настроена каждая линия порта A
Режимы GPIO и биты CRL с нуля: ЛР1 GPIO на ассемблере Адрес пина адрес регистра пина Карта выводов где какая ножка на плате
В GPIOA->CRL лежат настройки линий 0–7, по 4 бита на линию (тетрада = одна hex-цифра). Линия n занимает биты 4n…4n+3: младшие два бита MODE, старшие два CNF (). Значит, hex-цифры читаются справа налево: самая правая цифра относится к PA0. Что означает каждая тетрада, сказано в . Для входа с подтяжкой направление выбирает бит ODR: 0 означает подтяжку к земле, 1 к питанию (там же, столбец PxODR).
| Линия | Тетрада CRL | CNF MODE | Бит ODR (0xC8) | Режим | Подключено |
|---|---|---|---|---|---|
| PA0 | 0 | 00 00 | 0 | аналоговый вход | кнопка |
| PA1 | 8 | 10 00 | 0 | вход с подтяжкой к 0 (pull-down) | кнопка |
| PA2 | 8 | 10 00 | 0 | вход с подтяжкой к 0 | кнопка |
| PA3 | 8 | 10 00 | 1 | вход с подтяжкой к 1 (pull-up) | кнопка |
| PA4 | 8 | 10 00 | 0 | вход с подтяжкой к 0 | кнопка |
| PA5 | 2 | 00 10 | 0 | выход push-pull, до 2 МГц | B, погашен |
| PA6 | 2 | 00 10 | 1 | выход push-pull, до 2 МГц | G, горит |
| PA7 | 2 | 00 10 | 1 | выход push-pull, до 2 МГц | R, горит |
| PA8–PA15 | CRH не трогали | 01 00 | — | плавающий вход (состояние после сброса) | — |
0x22288880 по тетрадам справа налево: 0, 8, 8, 8, 8, 2, 2, 2. CRH после сброса равен 0x4444 4444 (), тетрада 4 означает плавающий вход (). Аналоговый режим: Read access to the Input Data register gets the value “0”.
() Значит, PA0 никогда не даст фронт.
Ответ на 1. PA0 аналоговый вход. PA1, PA2, PA4 входы с подтяжкой к земле. PA3 вход с подтяжкой к питанию. PA5–PA7 выходы push-pull с максимальной частотой 2 МГц. PA8–PA15 остаются плавающими входами после сброса. Тактирование порта A включено битом IOPAEN (бит 2 RCC_APB2ENR, ). Светодиод после настройки горит жёлтым (R+G).
Вопрос 2. Какое прерывание самое приоритетное
PRIGROUP с калькулятором и четыре сценария вытеснения на временной шкале: ЛР2 PRIGROUP подробно ЛР2 сценарии
Шаг 1. Граница между группой и субприоритетом. В SCB->AIRCR = 0x05FA0400 верхние 16 бит 0x05FA служат ключом, без которого запись игнорируется. Биты 10:8 задают PRIGROUP (). 0x0400 означает, что бит 10 = 1, то есть PRIGROUP = 100. По Table 45 () это 3 бита группы [7:5] и 1 бит субприоритета [4].
Шаг 2. Число в IPR → группа и субприоритет. Процессор хранит только биты [7:4] каждого байта приоритета, младшие читаются как 0 (). Чем меньше число, тем приоритет выше. Номера IRQ взяты из таблицы векторов ().
| Прерывание | IRQ | IPR (дес.) | hex | [7:4] | группа [7:5] | суб [4] | Включено в ISER? |
|---|---|---|---|---|---|---|---|
| EXTI0 | 6 | 44 | 0x2C | 0010 | 001 = 1 | 0 | нет (бит 6 = 0) |
| EXTI1 | 7 | 99 | 0x63 | 0110 | 011 = 3 | 0 | да |
| EXTI2 | 8 | 171 | 0xAB | 1010 | 101 = 5 | 0 | да |
| EXTI3 | 9 | 163 | 0xA3 | 1010 | 101 = 5 | 0 | да |
| EXTI4 | 10 | 9 | 0x09 | 0000 | 000 = 0 | 0 | да |
EXTI2 и EXTI3 получили одинаковые группу и субприоритет: 171 и 163 различаются только в младшей тетраде, а её процессор отбрасывает. Тогда решает номер: If multiple pending interrupts have the same group priority and subpriority, the interrupt with the lowest IRQ number is processed first.
() Значит, EXTI2 идёт раньше EXTI3. Зато друг друга они не вытесняют: Only the group priority determines preemption of interrupt exceptions.
()
Ответ на 2. Самое приоритетное EXTI4: группа 0, все остальные в группах 1–5. Дальше по убыванию: EXTI0 (группа 1, но оно выключено в NVIC и на аналоговой линии, поэтому никогда не выполнится), EXTI1 (группа 3), EXTI2 и EXTI3 (группа 5, между собой по номеру IRQ, сначала EXTI2). Вытеснить друг друга могут только прерывания из разных групп.
Вопрос 3. В каком порядке меняются цвета
Какие фронты что вызывают. Литералы восьмеричные, переводим по три бита на цифру:
| Регистр | Литерал | Двоичная | Линии | Смысл () |
|---|---|---|---|---|
| FTSR | 023 | 010 011 | 0, 1, 4 | прерывание по заднему фронту (1→0, отпускание) |
| RTSR | 035 | 011 101 | 0, 2, 3, 4 | по переднему фронту (0→1, нажатие) |
| IMR | 037 | 011 111 | 0–4 | запросы линий 0–4 не замаскированы |
| ISER[0] | 0x0780 | 0111 1000 0000 | IRQ 7–10 | в NVIC включены EXTI1, EXTI2, EXTI3, EXTI4 |
AFIO не настраивали, но AFIO_EXTICR после сброса равен 0, а код 0000 означает PA[x], то есть порт A (). Поэтому линии EXTI 0–4 и так смотрят на PA0–PA4.
Итого: нажатие ставит в очередь EXTI2, EXTI3, EXTI4, отпускание ставит EXTI1 и EXTI4. EXTI0 мёртв трижды: PA0 аналоговый, в ISER нет бита 6, а у невключённого прерывания NVIC never activates the interrupt, regardless of its priority
().
PA3 подтянут к 1, поэтому на реальной плате нажатие кнопки не даёт на нём фронта: линия уже в 1. Но условие говорит «после переключения на красный цвет», а красный (только R) появляется только внутри EXTI3. Да и в эталоне преподавателя EXTI3 срабатывает («4 2 3 4 1»), и на его диаграмме все пять линий идут из 0 в 1 (строка 0x1F: 0 → 31). Значит, авторы считают, что нажатие даёт фронт 0→1 на всех линиях PA0–PA4. Отвечай по этой модели и добавь одну фразу: «при строгом учёте подтяжки PA3 к питанию фронта на PA3 не было бы, и EXTI3 не сработал бы». Это показывает, что ты понял режимы из вопроса 1.
Перед прогоном одно правило NVIC. Когда обработчик заканчивается, ядро смотрит, нет ли ждущего запроса, который приоритетнее того, к чему предстоит вернуться. Так будет в конце вложенного EXTI4: вернуться можно в прерванный EXTI3 (группа 5), а ждёт EXTI1 (группа 3). Новое исключение начинается, если оно is of higher priority than the exception being handled
(). Переход сразу из обработчика в обработчик, минуя возврат в прерванную программу, называется tail-chaining, по-русски хвостовой переход (там же). В прогоне он встретится несколько раз.
Дальше прогон по шагам. Кнопки ‹ › или стрелки клавиатуры, когда фокус на стенде. Справа от светодиода значения ODR и val, ниже стек: что выполняется сейчас (рамка) и что ждёт в очереди (пунктир).
Ответ на 3. До нажатия жёлтый (R+G). Нажали: EXTI4 → белый, затем EXTI2 → жёлтый, затем EXTI3 → красный. Отпустили во время красного: EXTI4 вытесняет EXTI3 → пурпурный (R+B), затем EXTI1 тоже вытесняет EXTI3 → снова пурпурный, в конце EXTI1 гаснет R → синий. EXTI3 дорабатывает, синий остаётся. Порядок входа в обработчики: 4, 2, 3, 4, 1. Мгновенные состояния без задержки (зелёный между EXTI4 и EXTI2, полностью погашенный светодиод между EXTI4 и EXTI1) по условию считаются глитчами, их не учитываем.
Вопрос 4. Чему равно val
| Когда | Строка | Вычисление | val |
|---|---|---|---|
| старт | — | — | 0x0000 0000 |
| конец EXTI4 (нажатие) | val |= ~val>>val | ~0 = 0xFFFFFFFF, сдвиг на 0 ничего не меняет | 0xFFFF FFFF |
| конец EXTI2 | val &= 111 | 111 десятичное = 0x6F = 0110 1111 | 0x0000 006F |
| конец EXTI4 (отпускание, вложен в EXTI3) | val |= ~val>>val | сдвиг на 0x6F = 111 позиций ≥ 32, результат 0 | 0x0000 006F |
| конец EXTI1 | val |= 0111 | 0111 восьмеричное = 73 = 0x49 = 0100 1001, все его единицы уже есть в 0x6F | 0x0000 006F |
| конец EXTI3 | val <<= 0b111 | сдвиг влево на 7: 0x6F × 128 = 14208 | 0x0000 3780 |
Про сдвиг на 111. Компилятор переводит ~val>>val в команду LSRS Rd, Rm со сдвигом на регистр (я собрал этот код arm-none-eabi-gcc и посмотрел дизассемблер). У такой команды Only the least significant byte is used and can be in the range 0 to 255.
() Для LSR при этом действует правило If n is 32 or more, then all the bits in the result are cleared to 0.
() В самом языке Си сдвиг на ширину типа и больше считается неопределённым поведением (стандарт C11, п. 6.5.7). Так что результат 0 — свойство Cortex-M3, а не Си. Если спросят, отвечай именно так.
Ответ на 4. val = 0x3780 (14208). Он совпадает с последним значением на диаграмме преподавателя. Обработчик EXTI0 с val ^= 0x111 не выполнился ни разу.
Нажатие: EXTI4 (белый, val = 0xFFFFFFFF), EXTI2 (жёлтый, val = 0x6F). Красного нет. Отпускание: EXTI4 (пурпурный, val = 0x6F), EXTI1 (пурпурный, затем синий, val = 0x6F). Ответ был бы «4 2 4 1», val = 0x6F. Пишу это на случай, если на КР попадётся вариант, где подтяжка очевидно мешает.
Тренировка: новый вариант той же задачи
На КР, скорее всего, будет этот же код с другими числами. Генератор меняет режимы линий, начальный ODR, AIRCR, IPR, FTSR/RTSR/IMR (в разных системах счисления), ISER, маски ODR и операции над val в обработчиках. Ответы считает та же модель, по которой разобран вариант выше: на прошлогодних числах она выдаёт ровно эталон преподавателя (4 2 3 4 1, 0x3780). Кнопку отпускают в первый момент, когда горит только красный. Генератор выбирает варианты, где красный появляется, и чаще всего такие, где есть вытеснение.
Ответь на четыре вопроса задания: 1) режим каждой линии порта A; 2) самое приоритетное прерывание; 3) порядок цветов при нажатии и отпускании после красного; 4) значение val.
Показать ответы и прогон по шагам
03Задача Б: написать три функции
Дана следующая программа для микроконтроллера STM32F103C8T6:
#include "stm32f10x.h"

// прототипы функций
void RCC_Configure(void);
void GPIO_Configure(void);
void EXTI_NVIC_Configure(void);
void Error_Handler(void);

int main(void) {
    // 1. настройка системы тактирования
    RCC_Configure();

    // 2. настройка портов GPIO
    GPIO_Configure();

    // 3. настройка линий EXTI и контроллера прерываний (NVIC)
    EXTI_NVIC_Configure();

    // бесконечный цикл
    while(1) {
        // основная программа
    }
}
Вам необходимо написать реализацию трех функций, так, чтобы выполнялись следующие условия:
- Функция RCC_Configure(); должна настраивать систему тактирования микроконтроллера таким образом, чтобы частота шины AHB была 27Мгц. Считать, что внешний источник татирования HSE имеет частоту 6Мгц.
- Функция GPIO_Configure(); должна настаивать порт GPIOB следующим образом: Линии с 0 по 3 используются как входы с поддяжкой к 0. Линии с 4 по 7 - входы с подтяжкой к 1. Линии с 8 по 15 - как выходы в режиме Open drain.
- Функция EXTI_NVIC_Configure(); должна настраивать систему прерываний так, чтобы формировались прерывания от линий 0,2,4 порта GPIOB по переднему фронту, от линий 1,7 порта GPIOB по заднему фронту. Приоритеты прерываний должны быть прямо пропорциональны номеру линии (т.е. прерывания от линии 7 самое приоритетное), но при этом прерывания не должны прерывать друг друга, кроме прерывания от 7 линии. Так же прерывание от системного таймера SysTick должно иметь больший приоритет, чем любое из внешних прерываний и прерывать их работу.
Под условием в LMS поле ответа с заготовками трёх функций: в каждой // TODO.
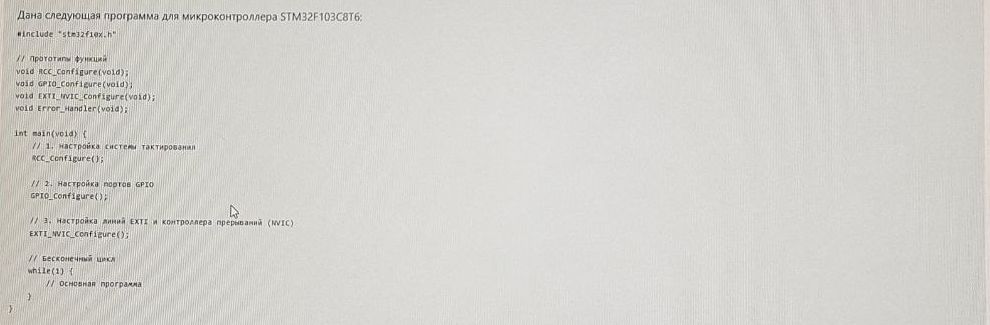
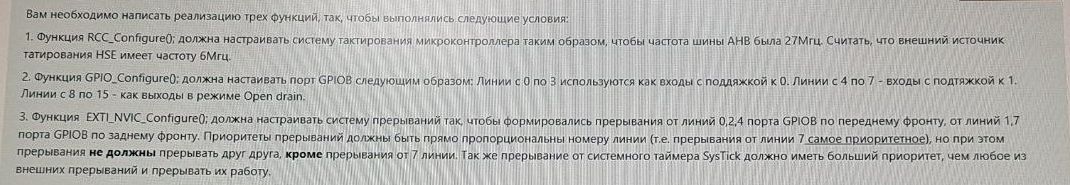
Ниже порядок рассуждения для каждой функции, со ссылками на нужные страницы. Попробуй написать сам и только потом открывай спойлер.
RCC_Configure: AHB = 27 МГц из HSE 6 МГц
Та же задача для 18 МГц со стендом тактирования: ЛР3 дерево тактирования ЛР3 откуда взять частоту ЛР3 такты флеша ЛР3 перенастройка по шагам Си SystemInit и 72 МГц
- Подобрать множители. Частота AHB (HCLK) = SYSCLK ÷ делитель HPRE. PLL умножает на 2…16 (), а на его вход можно подать HSE целиком или HSE÷2 (бит
PLLXTPRE, там же). 27 = 3 × 9, поэтому самый короткий путь: HSE ÷ 2 = 3 МГц, × 9 = 27 МГц, HPRE = ÷1. Другой путь тоже верный: 6 × 9 = 54 МГц, HPRE ÷ 2 = 27. - Проверить пределы. Вход PLL от 1 до 25 МГц, выход от 16 до 72 МГц (): 3 и 27 подходят. APB1 не выше 36 МГц (): 27 подходит, делители APB ÷1.
- Такты ожидания флеша по SYSCLK.
One wait state, if 24 MHz < SYSCLK ≤ 48 MHz
(). При 27 МГц нужен 1 такт (FLASH->ACR, LATENCY = 1). Во втором пути SYSCLK = 54 МГц, там уже 2 такта. Об этом чаще всего забывают. - Порядок действий: включить HSE и дождаться HSERDY (), выставить LATENCY, записать в
RCC_CFGRPLLSRC, PLLXTPRE и PLLMUL, включить PLL и дождаться PLLRDY (), переключить SW на PLL и дождаться, пока SWS станет PLL (). - Ловушка проекта Keil. До
mainотрабатываетSystemInitи уже включает PLL. Биты PLL вRCC_CFGRcan be written only when PLL is disabled
(). Поэтому сначала переходим на HSI и выключаем PLL. Подробно этот разбор есть в конспекте ЛР3.
GPIO_Configure: порт B
- Включить тактирование:
IOPBEN(бит 3) и сразуAFIOEN(бит 0) для EXTI (). - PB0–PB7 все входы с подтяжкой: тетрада
1000= 8, CRL =0x88888888. Направление подтяжки задаёт ODR: биты 0–3 = 0 (к земле), биты 4–7 = 1 (к питанию) (). - PB8–PB15 выходы open-drain: CNF =
01, MODE ≠ 00 выбирает скорость. Скорость в условии не задана, любая подойдёт, только назови её: 2 МГц →0110= 6, 10 МГц → 5, 50 МГц → 7 ().
EXTI_NVIC_Configure: самое интересное
Си NVIC и приоритеты по-сишному Си битовые операции ЛР2 калькулятор: вывод → регистры
- Порт B на линии EXTI.
AFIO_EXTICR1отвечает за линии 0–3,EXTICR2за линии 4–7, по 4 бита на линию, код порта B0001(). Без включённого AFIO запись в эти регистры не сработает (). - Фронты: RTSR биты 0, 2, 4. FTSR биты 1, 7. IMR биты 0, 1, 2, 4, 7.
- Номера IRQ. Линии 0, 1, 2, 4 имеют свои IRQ 6, 7, 8, 10. Линия 7 сидит в общем EXTI9_5, IRQ 23 (). Обработчик тогда тоже общий,
EXTI9_5_IRQHandler. - Подобрать PRIGROUP. Требования: SysTick вытесняет всех, линия 7 вытесняет остальные EXTI, а 0, 1, 2, 4 друг друга не вытесняют. Получается три уровня группы: SysTick, линия 7, все остальные. Внутри последней группы нужен порядок 4 > 2 > 1 > 0, это четыре уровня субприоритета. Значит, нужно минимум 2 бита на группу и 2 бита на субприоритет. При 4 битах это ровно PRIGROUP =
101(Table 45, ). PRIGROUP =100не годится: там один бит субприоритета, то есть два уровня на четыре линии. Две линии неизбежно получат одинаковый субприоритет, и между ними раньше пойдёт меньший номер IRQ (), а у нас номер IRQ растёт вместе с номером линии. Нужен же обратный порядок. - Числа в IPR: старшая тетрада = (группа << 2) | суб, затем сдвиг на 4 влево. SysTick лежит не в NVIC, а в
SCB_SHPR3, биты 31:24 (). В CMSIS 6 этоSCB->SHPR[11], в CMSIS 5SCB->SHP[11]. Проще всегоNVIC_SetPriority(SysTick_IRQn, 0).
Показать решение (сначала попробуй сам)
Собрано arm-none-eabi-gcc с заголовками из пакета Keil (STM32F1xx_DFP 2.4.1, CMSIS 6.1), без ошибок и предупреждений. Записанное в RCC_CFGR значение 0x001F0000 проверено на твоей плате в ЛР3 (вариант A там отличался только делителем AHB).
void RCC_Configure(void){
    uint32_t t = 0;
    RCC->CFGR &= ~RCC_CFGR_SW;                /* 0. уйти на HSI, если SystemInit включила PLL */
    while((RCC->CFGR & RCC_CFGR_SWS) != RCC_CFGR_SWS_HSI);
    RCC->CR &= ~RCC_CR_PLLON;                 /*    и выключить PLL: иначе PLLMUL не запишется */
    while(RCC->CR & RCC_CR_PLLRDY);

    RCC->CR |= RCC_CR_HSEON;                  /* 1. включить HSE (6 МГц)            */
    while(!(RCC->CR & RCC_CR_HSERDY))
        if(++t > 100000) Error_Handler();      /*    кварц не завёлся               */

    FLASH->ACR = FLASH_ACR_PRFTBE | 1;        /* 2. SYSCLK 27 МГц > 24 → 1 такт     */

    RCC->CFGR = RCC_CFGR_PLLSRC               /* 3. вход PLL — HSE                  */
              | RCC_CFGR_PLLXTPRE             /*    ÷2 → 3 МГц                      */
              | RCC_CFGR_PLLMULL9;            /*    ×9 → 27 МГц; HPRE, PPRE1, PPRE2 = ÷1 */
    RCC->CR |= RCC_CR_PLLON;                  /* 4. включить PLL                    */
    while(!(RCC->CR & RCC_CR_PLLRDY));

    RCC->CFGR |= RCC_CFGR_SW_PLL;             /* 5. SYSCLK = PLL                    */
    while((RCC->CFGR & RCC_CFGR_SWS) != RCC_CFGR_SWS_PLL);
}

void GPIO_Configure(void){
    RCC->APB2ENR |= RCC_APB2ENR_IOPBEN | RCC_APB2ENR_AFIOEN;
    GPIOB->CRL = 0x88888888;   /* PB0..7: вход с подтяжкой (CNF 10, MODE 00)    */
    GPIOB->CRH = 0x66666666;   /* PB8..15: выход open-drain 2 МГц (CNF 01, MODE 10) */
    GPIOB->ODR = 0x000000F0;   /* PB0..3 → к 0, PB4..7 → к 1, выходы = 0       */
}

void EXTI_NVIC_Configure(void){
    AFIO->EXTICR[0] = 0x0111;   /* EXTI0, 1, 2 ← порт B */
    AFIO->EXTICR[1] = 0x1001;   /* EXTI4, 7 ← порт B    */

    EXTI->RTSR = (1<<0)|(1<<2)|(1<<4);   /* передний фронт: 0, 2, 4 */
    EXTI->FTSR = (1<<1)|(1<<7);          /* задний фронт: 1, 7      */
    EXTI->PR   = 0x97;                   /* сбросить старые запросы */
    EXTI->IMR  = (1<<0)|(1<<1)|(1<<2)|(1<<4)|(1<<7);

    SCB->AIRCR = 0x05FA0500;   /* PRIGROUP 101: 2 бита группы, 2 бита суб */

    SCB->SHPR[11]            = 0x00;  /* SysTick: группа 0       */
    NVIC->IPR[EXTI9_5_IRQn]   = 0x40;  /* линия 7: группа 1, суб 0 */
    NVIC->IPR[EXTI4_IRQn]     = 0x80;  /* группа 2, суб 0          */
    NVIC->IPR[EXTI2_IRQn]     = 0x90;  /* группа 2, суб 1          */
    NVIC->IPR[EXTI1_IRQn]     = 0xA0;  /* группа 2, суб 2          */
    NVIC->IPR[EXTI0_IRQn]     = 0xB0;  /* группа 2, суб 3          */

    NVIC->ISER[0] = (1<<EXTI0_IRQn)|(1<<EXTI1_IRQn)|(1<<EXTI2_IRQn)
                  | (1<<EXTI4_IRQn)|(1<<EXTI9_5_IRQn);   /* = 0x008005C0 */
}
Что стоит проговорить в ответе, если решение проверяют глазами:
- Почему PRIGROUP именно 101, а не 100 (пункт 4 выше).
- Почему LATENCY = 1 (SYSCLK 27 > 24).
- Что линия 7 приходит в общий обработчик EXTI9_5, и в нём надо проверять
EXTI->PRбит 7. - Скорость open-drain выбрана сама, условие её не задаёт.
Та же настройка приоритетов через CMSIS: NVIC_SetPriorityGrouping(5); NVIC_SetPriority(EXTI4_IRQn, NVIC_EncodePriority(5, 2, 0)); и так далее. Числа выходят те же.
04Навыки из списка «повторить» и тренажёры
Системы счисления и литералы Си
В Си систему счисления числа задаёт его префикс. На КР именно это проверяют вперемешку.
| Запись | Система | Пример из задачи | Десятичное | hex |
|---|---|---|---|---|
| 0x… | шестнадцатеричная | 0x111 | 273 | 0x111 |
| 0… | восьмеричная (ведущий ноль!) | 023 · 035 · 037 · 0111 | 19 · 29 · 31 · 73 | 0x13 · 0x1D · 0x1F · 0x49 |
| 0b… | двоичная (расширение GCC/Keil, в C23 стандарт) | 0b111 | 7 | 0x7 |
| без префикса | десятичная | 111 · 44 · 171 | 111 · 44 · 171 | 0x6F · 0x2C · 0xAB |
- hex ↔ двоичная: одна hex-цифра = 4 бита (тетрада).
0xA3 = 1010 0011. - oct ↔ двоичная: одна восьмеричная цифра = 3 бита (триада).
035 = 011 101. Чтобы перевести oct → hex, распиши в биты и перегруппируй по 4 справа. - dec → любая: дели на основание, остатки читай снизу вверх. 171 = 16·10 + 11 →
0xAB. Для IPR удобнее сразу dec → hex: старшая цифра и есть [7:4]. - любая → dec: сумма цифр, умноженных на степени основания.
0111(oct) = 64 + 8 + 1 = 73.
Тренажёр: переведи литерал
Введи десятичное значение и нажми «Проверить».
Герцы и микросекунды
ЛР3 что такое таймер ЛР3 PSC, ARR, режимы счёта
Период и частота обратны друг другу: T = 1 / f. Удобные пары: 1 МГц ↔ 1 мкс, 1 кГц ↔ 1 мс, 1 Гц ↔ 1 с. Значит, T [мкс] = 1 / f [МГц], f [МГц] = 1 / T [мкс].
| Частота | Период такта | Где встречается |
|---|---|---|
| 8 МГц | 0,125 мкс = 125 нс | HSI, кварц платы |
| 27 МГц | ≈ 0,037 мкс = 37,04 нс | задача Б |
| 72 МГц | ≈ 13,9 нс | максимум STM32F103 |
| 2 кГц | 500 мкс = 0,5 мс | таймер после PSC (ЛР3) |
Типовые вопросы: сколько тактов пройдёт за время t (N = t · f), сколько длится N тактов (t = N / f), какая частота у события раз в T. Для таймера: fсобытия = fтаймера / ((PSC+1)(ARR+1)). Для программной задержки: t = итерации × тактов на итерацию / f. Сколько тактов занимает итерация, документация не говорит. На твоей плате SUBS+BNE занимал 3 такта при 0 тактах ожидания флеша (измерено в ЛР0).
Калькулятор
Настройка GPIO: декодер CRL/CRH
Метод из вопроса 1: hex-цифры справа налево, каждая цифра → CNF MODE → Table 20. Вставь любые значения, и декодер распишет все 16 линий. Для тренировки сначала распиши сам, потом проверь.
Приоритеты прерываний: декодер
ЛР2 калькулятор PRIGROUP в ЛР2
Метод из вопроса 2: PRIGROUP → граница, IPR → только [7:4] → группа и субприоритет. Порядок в очереди: группа, затем субприоритет, затем номер IRQ. Вытесняет только меньшая группа. Значения можно писать в любой системе Си (171, 0xAB, 0253).
05Теория: экзаменационные вопросы 1–13
В него входят 9 тем: экзаменационные вопросы 2, 3, 4, 5, 6, 7, 8, 11, 13, причём вопрос 3 разбит на две темы: «микроконтроллеры и Cortex-M3» и «STM32F103C8: RCC, GPIO, прерывания, таймеры, АЦП, DMA, последовательные интерфейсы». Вопросов 1 (история), 9 (защита), 10 (Meltdown и Spectre) и 12 (кэш) в списке КР нет, они собраны в конце под отдельным заголовком: пригодятся на экзамене. В билете может быть и часть темы, поэтому по периферии STM32 каждый блок расписан отдельно.
Номера ниже — из экзаменационного списка 2024 года (Темы к экзамену 2024.pdf). У прошлогодников есть ответы Подготовка к экзамену/МПУС. Вопрос NN.pdf, но они короткие (150–300 слов) и местами общие. Поэтому всё ниже собрано по слайдам лекций из папки Теория/, каждый пункт ведёт на слайд. В каждом вопросе есть блок «как рассказать» — связный текст, который можно взять за основу письменного ответа. По вопросам 6, 7, 8, 12, 13 расписаны полные образцы, со схемами. Вопрос со звёздочкой уже попадался на КР.
То, чего нет на слайдах, помечено так: не со слайда. Наведи на пометку, чтобы увидеть, откуда это взято. Если преподаватель спросит «откуда», для таких мест ответ «из лекций» не подойдёт.
Как писать ответ на 10 баллов: определение, затем структура (формат, поля, разрядности), затем алгоритм (по шагам, что откуда берётся), затем достоинства и недостатки. Нарисуй хотя бы одну схему: формат селектора или дескриптора, путь адреса. Числа (разрядности, размеры) дают баллы лучше любых слов.
2Архитектура и микроархитектура, классификация, характеристикилекция 02
- МП — программно управляемое устройство для обработки цифровой информации и управления этой обработкой, выполненное в виде одной или нескольких СБИС (). МПС — функционально законченное изделие на основе МП ().
- Архитектура — логическая организация МП, определяемая его возможностями по аппаратной и программной реализации функций, неразрывно связана с системой команд (). Микроархитектура — аппаратная организация: регистры, управляющие схемы, АЛУ, ЗУ и магистрали; определяется реализацией у конкретного производителя (). Пример для ответа: x86-64 одна архитектура, у Intel и AMD разные микроархитектуры.не со слайда
- Классификация: универсальные МП, микроконтроллеры, процессоры ЦОС (). Универсальные делятся на CISC и RISC ().
- Характеристики как средства ВТ: разрядность, форматы данных, система команд и режимы адресации, ёмкость прямо адресуемой памяти, частота, производительность (). Как электронного устройства: синхронизация, питание, мощность рассеяния, логические уровни, корпус, помехоустойчивость, нагрузочная способность, надёжность, техпроцесс ().
Главное здесь — развести два понятия. Архитектура — это то, что видит программист: система команд, регистры, режимы адресации, модель памяти. Микроархитектура — как это устроено внутри конкретного кристалла: АЛУ, управляющие схемы, внутренние шины. Одну архитектуру могут реализовать разные микроархитектуры, и программа будет работать на всех. Классификация по назначению даёт три класса: универсальные МП (без жёстких ограничений по времени), микроконтроллеры (всё для системы управления на одном кристалле), процессоры ЦОС (сигналы и изображения). Универсальные делятся по системе команд на CISC и RISC. Характеристики удобно разделить на две группы: как вычислителя (разрядность, система команд, адресуемая память, производительность) и как электронного прибора (питание, мощность, корпус, надёжность).
3Микроконтроллеры, особенности архитектуры, ядро Cortex-M3лекции 03, 07
- МК — БИС со всеми устройствами для цифровой системы управления минимальной конфигурации (). Особенности: гарвардская архитектура, система команд под управление, простые режимы адресации, нет плавающей точки, есть битовые команды, встроенные АЦП/ЦАП ().
- ARM, профили A/R/M (). У Cortex-M нет MMU, может быть MPU.
- Блоки Cortex-M3 (): NVIC, SysTick, WIC (опция), отладка SW-DP/SWJ-DP, AHB-AP, DWT, ITM, FPB, ETM (опция), TPIU, MPU (опция), BusMatrix, мост AHB-APB. Шины: I-Code (команды), D-Code (данные), системная, PPB ().
- Адресное пространство: фиксированная карта 4 Гбайт, общая для памяти и периферии, область побитового доступа bit-band (). Общее и раздельное адресные пространства в целом ().
- STM32F103C8: Cortex-M3, 72 МГц, 64 КБ флеш, 20 КБ ОЗУ (). DMA (), RCC (), шины AHB/APB и мост (), EXTI (), GPIO, 37 линий (), таймеры, все 16-битные: TIM1 расширенный, TIM2–4 общего назначения (), интерфейсы I2C, SPI, UART, CAN, USB (), два 12-разрядных АЦП, 10 входов ().
- Прерывания: NVIC + EXTI, «Всего 59 прерывания + 15 системных» (). Номера 1–15 системные, 16+ внешние (). 16 уровней приоритета ().
Микроконтроллер — это вся система управления на одном кристалле. Отсюда его особенности: гарвардская архитектура (раздельные шины команд и данных), система команд для управления и работы с битами, встроенная периферия вместо внешних микросхем. Ядро Cortex-M3 (профиль M у ARM) — это не только процессор, но и NVIC, SysTick, средства отладки и матрица шин. MMU у него нет, адресное пространство одно на 4 Гбайт с фиксированной картой: флеш, ОЗУ, периферия, область побитового доступа. STM32F103C8 добавляет к ядру периферию ST, и каждый блок можно описать одной фразой: RCC раздаёт тактовые сигналы и включает блоки, GPIO — 37 линий ввода-вывода, EXTI + NVIC — прерывания, таймеры TIM1–TIM4 — время и ШИМ, два 12-разрядных АЦП, DMA пересылает данные без процессора, интерфейсы I2C, SPI, UART, CAN, USB. Для примеров бери свои лабы: GPIO из ЛР1, прерывания из ЛР2, RCC и таймеры из ЛР3.
Подробности по каждому блоку есть в лекциях 04 (RCC), 06 (GPIO), 08 (таймеры), 09 (АЦП), 10 (DMA), 11 (интерфейсы) и в твоих конспектах ЛР1–ЛР3.
3+STM32F103C8: RCC, GPIO, прерывания, таймеры, АЦП, DMA, интерфейсылекции 04, 06–11
Отдельная тема официального списка. Вопрос может быть про один блок («Таймеры STM32F103C8»), поэтому каждый блок расписан как короткий самостоятельный ответ: что это, из чего состоит, какие регистры, пример из лаб.
RCC — сброс и тактирование
ЛР3 дерево тактирования ЛР3 перенастройка по шагам
RCC (Reset and clock control) управляет сбросом и частотами (). Сброс бывает по питанию, системный и резервного домена (). Системный сброс вызывают низкий уровень на NRST, сторожевые таймеры WWDG и IWDG, программный сброс, выход из Standby и режимы низкого потребления; вектор сброса лежит по адресу 0x0000_0004 (). Источники тактирования: HSI — встроенный RC-генератор 8 МГц, HSE — внешний кварц 4–16 МГц, LSE — кварц 32768 Гц, LSI — RC-генератор 40 кГц (). Системную частоту SYSCLK даёт HSI, HSE или PLL (умножитель частоты); дальше делители дают частоты шин AHB, APB1, APB2 и АЦП. Всё это задаётся в RCC_CR (включение и готовность HSI, HSE, PLL) и RCC_CFGR (PLLSRC, PLLXTPRE, PLLMUL, делители HPRE, PPRE1, PPRE2, ADCPRE, выбор SW и его статус SWS) (). Каждому периферийному блоку тактирование включают битом в RCC_AHBENR, RCC_APB1ENR или RCC_APB2ENR; после сброса включены только память и флеш (). Ограничения: APB1 не выше 36 МГц (), с ростом SYSCLK нужны такты ожидания флеша (). Пример — задача Б: 27 МГц из HSE 6 МГц.
GPIO — порты ввода-вывода
ЛР1 GPIO на ассемблере Адрес пина адрес пина Карта выводов выводы Blue Pill
Порты 16-разрядные, у STM32F103C8 37 линий: PA[15:0], PB[15:0], PC[15:13], PD[1:0] (). Каждую линию можно настроить в один из восьми режимов: вход плавающий, с подтяжкой к 1, с подтяжкой к 0, аналоговый; выход open-drain или push-pull; альтернативная функция open-drain или push-pull (). У open-drain нет подключения к единице: вывод либо прижат к нулю, либо «висит». Это нужно для 5-вольтовой логики и для двунаправленных линий вроде I2C (). Регистры порта: CRL и CRH (по 4 бита на линию: MODE и CNF), IDR (чтение входов), ODR (выход, а для входа с подтяжкой — направление подтяжки), BSRR (атомарная установка и сброс отдельных битов), BRR, LCKR (блокировка настроек до сброса) (). Альтернативные функции можно переназначить на другие ножки через AFIO_MAPR, предварительно включив AFIOEN (). Как читать CRL по тетрадам, разобрано в задаче А, тренажёр — в главе 04.
Система прерываний
ЛР2 Прерывания ЛР2 все регистры одним списком
NVIC в ядре плюс EXTI для внешних линий: всего 59 прерываний периферии и 15 системных исключений (), 16 уровней приоритета с делением на группу и субприоритет (). EXTI даёт до 19 линий с выбором фронта и маскированием (). Весь путь от ножки до обработчика, с регистрами и ловушками, — в главе 01; её можно пересказать почти целиком.
Таймеры
ЛР3 SysTick ЛР3 режимы и теневые регистры ЛР3 TIM1
Таймеры отсчитывают интервалы, измеряют длительность импульсов, формируют ШИМ и считают внешние события (). Виды (, ):
- SysTick — простейший 24-битный таймер в ядре, считается частью NVIC, 4 регистра CTRL, LOAD, VAL, CALIB. Источник — AHB или AHB/8 ().
- Базовый: 16-битный счётчик, 16-битный предделитель (деление от 1 до 65536), регистр перезапуска, прерывание или запрос DMA по переполнению ().
- Общего назначения (TIM2–TIM4 у нашего чипа): всё то же плюс до 4 каналов захвата и сравнения, ШИМ, одиночные импульсы, энкодеры, синхронизация таймеров (). Расширенный TIM1 добавляет комплементарные выходы с dead-time, счётчик повторений и вход BRK (, ).
Режимы счёта: вверх до ARR, вниз от ARR, центрированный (). Предделитель делит входную частоту на PSC+1 (), ARR задаёт значение перезагрузки (). Отсюда частота событий обновления при счёте вверх: f / ((PSC+1)·(ARR+1)).формула выведена Новые PSC и ARR применяются через теневые регистры только на следующем событии обновления (). Каналы: захват запоминает значение счётчика по фронту на входе, сравнение выдаёт сигнал при совпадении с CCR (). ШИМ режима 1: выход 1, пока CNT < CCR, иначе 0; режим 2 инвертирует (). Пример — ЛР3: SysTick и TIM1.
АЦП
Два 12-разрядных АЦП, 10 внешних входов (). Есть прерывания по концу преобразования (EOC), по концу инжектированной группы и от аналогового сторожа, одиночный и непрерывный режимы, самокалибровка, запуск от внешнего события, работа с DMA (). Каналы делятся на регулярные — группа до 16 каналов в любом порядке, с повторами — и инжектированные — до 4 каналов, которые прерывают регулярное преобразование (). Режимы: одиночное измерение, сканирование группы (результаты забирает DMA), непрерывное (). Два АЦП могут работать вместе, с чередованием до 2 млн выборок в секунду (). Оконный компаратор (analog watchdog) даёт прерывание, когда результат выходит за заданные границы (). Время выборки от 1,5 до 239,5 циклов задаётся для каждого канала ().
DMA
Контроллер прямого доступа к памяти пересылает данные между периферией и памятью без процессора; процессор в это время занят другим (). Семь независимых каналов; передача запускается по запросу устройства, арбитр выбирает канал по одному из 4 уровней приоритета; есть прерывания по завершении и циклический режим (). Каждый канал обслуживает свой ограниченный набор устройств (или запускается программно) и выдаёт одно прерывание по трём событиям: половина передачи, вся передача, ошибка (). Канал настраивают в DMA_CCRx (направление, циклический режим, инкремент адресов периферии и памяти, размеры данных, приоритет), DMA_CNDTRx (сколько данных) и DMA_CPARx/DMA_CMARx (адреса) (). Типичный пример — АЦП в режиме сканирования пишет результаты в массив через DMA.
Последовательные интерфейсы
USART: синхронный или асинхронный обмен в полном дуплексе, аппаратное управление потоком, полудуплекс по одному проводу, мультипроцессорный режим, ИК-порт, LIN, смарт-карты (). В асинхронном режиме (UART) тактового сигнала может не быть, стоповый бит — от 0,5 до 2 (). SPI: синхронный интерфейс, где ведущий задаёт тактирование и управляет передачей (). Сигналы: MOSI (от ведущего к ведомому), MISO (обратно), SCLK (такт), CS/SS (выбор ведомого) (); несколько ведомых выбираются своими CS (). I2C в лекции 11 не разобран: он только назван среди интерфейсов () и упомянут как пример линии с открытым стоком ().
4Структура универсального МПлекция 12
- Общая схема IA-32 (): процессор чисел с фиксированной точкой, процессор с плавающей точкой, MMU, кэш, блок управления, блок интерфейса внешней шины, внутренняя магистраль.
- Фиксированная точка: 32-разрядное АЛУ, знаковые числа в дополнительном коде, 8 РОН по 32 бита, часть доступна по 16 и 8 бит (). Плавающая точка: 80-разрядное АЛУ, 8 регистров по 80 бит, управляющие регистры ().
- MMU состоит из блока сегментации и блока страничного преобразования (с TLB) (). Кэш — ступень между ОП и регистрами ().
- Блок управления: устройство управления (код команды → управляющие сигналы), управление защитой, предвыборка команд в буфер на 32 байта (). Интерфейс внешней шины: согласование с внешними магистралями адреса, данных и управления ().
Нарисуй схему со слайда 2 и пройди по ней путь команды. Блок интерфейса внешней шины получает команды и данные из памяти. Блок предвыборки заранее заполняет 32-байтный буфер команд. Устройство управления по коду команды вырабатывает управляющие сигналы. Вычисления идут в одном из двух процессоров: целочисленном (32-разрядное АЛУ и восемь РОН) или с плавающей точкой (80-разрядное АЛУ и восемь 80-битных регистров). Каждый адрес памяти проходит через MMU: блок сегментации, затем страничный блок с TLB. Кэш стоит между памятью и регистрами и хранит то, что скорее всего понадобится снова. Блок управления защитой проверяет права при работе с памятью. Так ответ сразу связывается с вопросами 6–9 и 12.
5Регистровая структура универсального МПлекция 13
- РОН: EAX, EBX, ECX, EDX, ESI, EDI, EBP, ESP; 16-битные AX… и 8-битные AH/AL…; в AMD64 RAX… и R8–R15 ().
- Указатель команд IP/EIP/RIP и флаги FLAGS/EFLAGS/RFLAGS: признаки ZF, SF, OF, CF; управляющие IF, TF, NT, IOPL, VM ().
- Сегментные: шесть 16-разрядных CS, DS, SS, ES, FS, GS (). В защищённом режиме в них лежат селекторы, связь с вопросом 7.
- FPU: R0–R7 по 80 бит (как стек), 64-битная часть служит регистрами MMX MM0–MM7 ().
- Системные: CR0–CR4 и регистры системных адресов (GDTR, LDTR, IDTR, TRперечень не со слайда), только в защищённом режиме и только на максимальном уровне привилегий (). Отладки DR0–DR7 и тестирования TR ().
Регистры удобно делить по тому, кто ими пользуется. Прикладной программе доступны РОН (восемь 32-битных EAX…ESP, части по 16 и 8 бит, в AMD64 — 64-битные RAX… и ещё R8–R15), указатель команд EIP, регистр флагов EFLAGS (признаки результата и флаги управления) и шесть сегментных регистров CS, DS, SS, ES, FS, GS. Для вещественных чисел есть восемь 80-битных регистров FPU, они же служат регистрами MMX. Операционной системе нужны системные регистры: управляющие CR0–CR4 и регистры таблиц и задачи. Доступны они только в защищённом режиме и только на нулевом уровне привилегий. Отдельно стоят регистры отладки DR0–DR7 (адреса точек останова) и тестирования (кэш и TLB). Связь с вопросами 7 и 11: в защищённом режиме в сегментных регистрах лежат селекторы, а TR указывает на текущую задачу.
6Организация памяти: ФАП и четыре вида ЛАПлекция 14
Если придёт формулировка вопроса 6, отвечать надо про все четыре вида ЛАП, а сегментацию и страницы подробно не расписывать: это вопросы 7 и 8.
Физическое адресное пространство — одномерный массив байтов, к которому аппаратура памяти обращается по адресу, выставленному на шину адреса. Его размер задаёт разрядность шины. Логическое адресное пространство — то, как память видит программа. Его организует программист под свою задачу, а переводит логические адреса в физические блок управления памятью MMU ().
Виды ЛАП ():
- Плоское (линейное). Логический адрес равен физическому (). Это просто и быстро, но нет ни изоляции программ, ни защиты. Так устроена память в микроконтроллерах, например в STM32.
- Сегментированное. Память состоит из сегментов — непрерывных областей переменной длины. Адрес = сегмент + смещение. В реальном режиме база сегмента = 16-битный сегментный адрес × 16, сегмент до 64 Кбайт, всего 1 Мбайт (). В защищённом режиме сегмент описан дескриптором с базой, пределом и правами доступа, до 4 Гбайт (). Недостатки: сегмент не может быть больше физической памяти, его надо загружать целиком, память фрагментируется ().
- Страничное. Логическая и физическая память делятся на страницы одинакового размера, в IA-32 это 4 Кбайт. Адрес = номер страницы + смещение в ней, соответствие задают таблицы страниц (). Программа видит 4 Гбайт виртуальной памяти, а в ОЗУ лежат только нужные страницы. Остальные подгружаются по требованию: обращение к отсутствующей странице вызывает ошибку, и ОС её загружает ().
- Сегментно-страничное. Сегменты состоят из страниц. Сначала сегментация переводит логический адрес в линейный, потом страничный блок переводит линейный в физический. Если страничное преобразование выключено, линейный адрес и есть физический (). Так работает IA-32 начиная с i386 ().
Итог для сравнения. Сегменты отражают логику программы (код, данные, стек) и удобны для защиты, но фрагментируют память. Страницы удобны для управления памятью и виртуальной памяти. Сегментно-страничная схема даёт и то, и другое.вывод не со слайда
7★ Сегментное логическое адресное пространстволекция 14
Этот вопрос был в сливе. Ниже образец письменного ответа, примерно на 10 баллов. Пиши своими словами, но сохрани порядок и все числа. Ссылки на слайды стоят, чтобы ты сверил каждое утверждение.
1. Физическое и логическое адресное пространство
Физическое адресное пространство (ФАП) — одномерный массив байтов, к которому аппаратура памяти обращается по адресу на шине адреса. Логическое (ЛАП) организует программист под свои задачи. Трансляцию логических адресов в физические осуществляет блок управления памятью MMU.
()
Варианты ЛАП: плоское (массив байтов, логический адрес = физическому), сегментированное (сегменты — непрерывные области переменной длины), страничное (страницы фиксированного размера), сегментно-страничное ().
2. Сегментация в реальном режиме (8086)
Логический адрес = 16-битный адрес сегмента + 16-битное смещение. Физический адрес (20 бит) = адрес сегмента × 24 + смещение. Сегмент не больше 64 Кбайт, вся память 1 Мбайт (). Пример: 1234h:0010h → 12340h + 0010h = 12350h.пример свой
3. Сегментация в защищённом режиме
Адресуется до 4 Гбайт. Сегменты переменной длины, могут пересекаться, у каждого свой уровень прав доступа (). Сведения о сегменте лежат в дескрипторе, а логический адрес состоит из селектора (16 бит) и смещения (32 бита).
Дескриптор сегмента занимает 8 байт ():
- базовый адрес, 32 бита — где сегмент начинается;
- предел, 20 бит — размер сегмента. При G = 0 он в байтах (до 220 = 1 Мбайт), при G = 1 в страницах по 4 Кбайт (до 4 Гбайт);
- байт доступа: P (сегмент присутствует в памяти), DPL (уровень привилегий сегмента), S, ТИП (код, данные или системный объект), A (было обращение);
- атрибуты G, D, X, U.
Таблицы дескрипторов лежат в памяти и сами являются сегментами ():
- GDT, глобальная, одна на систему. Её база (32 бита) и предел (16 бит) хранятся в регистре GDTR.
- LDT, локальные, их много, у каждой задачи может быть своя. Дескрипторы самих LDT лежат в GDT, текущую задаёт регистр LDTR.
- IDT, таблица дескрипторов прерываний (вопрос 13).
Селектор, 16 бит (): Index (13 бит, номер дескриптора в таблице), TI (1 бит: 0 — GDT, 1 — текущая LDT), RPL (2 бита, запрашиваемый уровень привилегий). Адрес дескриптора = база таблицы + Index × 23: умножаем на 8, потому что дескриптор занимает 8 байт. 13 бит индекса дают до 8192 дескрипторов в таблице.
4. Формирование адреса по шагам
- Смещение (эффективный адрес). Для кода это EIP, для данных его считает команда:
[Base] + [Index]·2SS + disp(). - Селектор берётся из сегментного регистра (CS, DS, SS…). По TI выбирается GDT (база из GDTR) или LDT (база из LDTR), по Index находится дескриптор ().
- Проверки: смещение не выходит за предел, тип операции разрешён, хватает привилегий (лекция 19, и ).
- Линейный адрес = базовый адрес сегмента из дескриптора + смещение, 32 бита.
- Если страничное преобразование выключено (PG = 0), линейный адрес и есть физический. Если включено, линейный адрес переводится в физический через каталог и таблицы страниц (, вопрос 8).
5. Кэширование дескрипторов
Читать дескриптор из памяти при каждом обращении было бы медленно. Поэтому у каждого сегментного регистра (и у LDTR) есть невидимый программисту теневой регистр. Когда селектор загружается в сегментный регистр, процессор один раз читает дескриптор из GDT/LDT, проверяет его и копирует в теневой регистр. Дальше база и предел берутся оттуда, без обращения к таблице (: «Теневой регистр LDT», «Теневой регистр сегмента»). Следствие: если поменять дескриптор в памяти, процессор этого не заметит, пока селектор не перезагрузят.
6. Недостатки сегментного ЛАП
Нельзя использовать сегмент больше физической памяти. Загрузка и выгрузка больших сегментов долгая, а сегмент приходится подгружать целиком. Память фрагментируется (). Эти проблемы решает страничная организация (вопрос 8).
На написано: «RPL – приоритет запроса. Должен быть ≥ поля DPL дескриптора». Речь о приоритете, а численно условие обратное. Точная формула доступа к сегменту данных на : max(CPL, RPL) ≤ DPL. Уровень 0 самый привилегированный. Пиши формулу, она однозначна.
8Виртуальная память, страничное ЛАП, TLBлекция 14
Виртуальная память позволяет программе обращаться к 4 Гбайт адресов, хотя физической памяти меньше. Для этого и виртуальная, и физическая память делятся на страницы одного размера (в IA-32 4 Кбайт), а адрес состоит из номера страницы и смещения в ней. Страницы, нужные сейчас, лежат в ОЗУ в любых свободных местах. Остальных в памяти нет: обращение к такой странице вызывает исключение, и ОС подгружает её ().
Почему таблица двухуровневая. При 4-Кбайтных страницах на номер страницы приходится 20 бит, это 220 записей по 4 байта — 4 Мбайт таблицы на каждую программу (). Поэтому линейный адрес делится на три поля: 10 бит — номер элемента каталога таблиц страниц (ЭКТС), 10 бит — номер элемента таблицы страниц (ЭТС), 12 бит — смещение. Адрес каталога хранится в CR3. ЭКТС даёт адрес таблицы страниц, ЭТС даёт адрес страницы, к нему прибавляется смещение (). Каталог и каждая таблица занимают ровно одну страницу: 1024 элемента × 4 байта. В памяти держат только каталог и те таблицы, которые нужны.
Элемент КТС/ТС — 32 бита: старшие 20 бит — адрес таблицы или страницы (младшие 12 бит адреса — нули, раз всё выровнено на 4 Кбайт), а в младших битах признаки: P — страница присутствует, R/W и U/S — права, A — было обращение, D — была запись, PCD и PWT — режим кэширования, плюс биты для ОС ().
TLB. Каждое обращение к памяти потребовало бы ещё двух чтений таблиц. Буфер ассоциативной трансляции хранит недавние пары «номер виртуальной страницы (тег) → номер физической страницы и атрибуты». При попадании адрес получается сразу, при промахе процессор проходит по таблицам и записывает результат в TLB (). Если TLB заполнен, новая запись вытесняет старую по одному из алгоритмов замещения: LRU, LFU, FIFO, случайно ().связь с TLB не со слайда
В AMD64 уровней четыре: 9 + 9 + 9 + 9 + 12 бит (), бывают и страницы по 2 Мбайт ().
- Идея: программа видит 4 Гбайт. Виртуальная и физическая память делятся на страницы одного размера (в IA-32 4 Кбайт), страницы нумеруются, адрес = номер страницы + смещение (). Пример с тремя программами и отсутствующей страницей (n.a. → ошибка → подгрузка) на .
- Почему двухуровневая таблица: 20 бит номера страницы и 12 бит смещения дают 220 записей по 4 байта, то есть 4 Мбайт таблицы на каждую программу. Это недопустимо ().
- Линейный адрес 10 + 10 + 12: номер элемента каталога таблиц страниц (ЭКТС), номер элемента таблицы страниц (ЭТС), смещение. База каталога лежит в CR3. В памяти держат только каталог и нужные таблицы по 4 Кбайт ().
- Элемент КТС/ТС (32 бита): старшие 20 бит — адрес таблицы или страницы, резерв ОС, D (была запись), A (было обращение), PCD (запрет кэширования), PWT (сквозная запись), U/S и R/W (права), P (страница присутствует) ().
- AMD64: 4 уровня 9 + 9 + 9 + 9 + 12 (PML4 → УКТС → КТС → ТС) (), большие страницы 2 Мбайт, смещение 21 бит ().
- TLB (буфер ассоциативной трансляции) — ассоциативная память, где номеру виртуальной страницы (тегу) сопоставлены номер физической страницы и атрибуты. При попадании (TLB hit) таблицы в памяти не читаются, при промахе (miss) выполняется обход таблиц, и результат записывается в TLB (). Запись: тег 20 бит, адрес, V, D, U/S, R/W, PWT, PCD ().
- Замещение строк: в лекции про TLB отдельно не сказано. Алгоритмы общие с кэшем: LRU, LFU, FIFO, Random (), псевдо-LRU ().связь с TLB не со слайда
- Полная картина сегментно-страничного преобразования, от команды до данных: .
11Многозадачность: TR, дескриптор TSS, TSS, переключение задачлекция 15
- Мультипрограммный режим: в памяти одновременно программы и данные нескольких задач. Состояния задачи: порождение, активное (счёт), ожидание, готовность, окончание (). Черты и ресурсы (), коэффициенты загрузки и пример с Kм = 1, 2, 3 ().
- TSS хранит селектор LDT, селекторы данных, кода и стеков, флаги, смещение, CR3, карту разрешения ввода-вывода, ссылку на предыдущий TSS. Селектор текущего TSS лежит в регистре TR ().
- Дескриптор TSS, байт доступа: P, DPL, 0, M, 0, B, 1. DPL — кто может переключиться на задачу. M = 0 — 16-битный режим совместимости с i286. B — бит занятости, вызов занятой задачи даёт прерывание ().
- Четыре случая переключения: JMP или CALL с селектором TSS в GDT; JMP или CALL с селектором шлюза задачи; вектор прерывания указывает на шлюз задачи; IRET (). Шлюз задачи, 8 байт, используется только селектор TSS, P, DPL ().
- Алгоритм переключения (): 1) найти дескриптор TSS; 2) сохранить контекст старой задачи в её TSS; 3) загрузить адрес TSS новой задачи; 4) загрузить контекст новой задачи; 5) сохранить селектор предыдущей задачи; 6) загрузить новый селектор в TR и запустить задачу.
- JMP и CALL: JMP не сохраняет ссылку возврата, ставит NT = 0, снимает B у старой и ставит B у новой. CALL ставит B = 1 новой, оставляет B = 1 старой и ставит NT ().
В мультипрограммном режиме в памяти одновременно несколько задач, и процессор переключается между ними, пока одни ждут ввода-вывода, другие считают. Так растёт загрузка процессора и пропускная способность: в примере со слайдов 6–10 при коэффициенте мультипрограммирования 2 четыре программы выполняются за 24 единицы времени вместо 36. Аппаратная поддержка в IA-32 состоит из трёх частей. Сегмент состояния задачи (TSS) хранит её контекст: регистры, селекторы, флаги, CR3, селектор LDT. Дескриптор TSS в GDT описывает этот сегмент, в нём есть бит занятости B. Регистр задачи TR хранит селектор TSS текущей задачи. Переключение запускается командой JMP или CALL на TSS или шлюз задачи, прерыванием через шлюз задачи или IRET. Процессор сам сохраняет контекст в старый TSS, загружает контекст из нового и записывает новый селектор в TR. Флаг NT и ссылка на предыдущую задачу позволяют вернуться по IRET после CALL.
13Прерывания и исключения, IVT, IDT, КПП, APIC, MSIлекции 16, 07
Прерывание — изменение естественного порядка выполнения программы, связанное с работой внешних устройств, ошибками и особыми ситуациями (). Аппаратные прерывания приходят от устройств асинхронно и бывают маскируемыми и немаскируемыми. Программные (исключения, особые случаи) возникают при выполнении команд и делятся на нарушения, ловушки и аварии. После нарушения команда выполняется заново, после ловушки — со следующей, авария снимает программу ().
Действия процессора. Прерывания распознаются на границе команд, у каждого есть тип 0–255. Процессор определяет тип, сохраняет как минимум EIP, CS и EFLAGS, находит адрес обработчика и передаёт ему управление (). Где искать адрес, зависит от режима. В реальном режиме это таблица векторов в самом начале памяти: вектор из 4 байт (IP и CS), адрес вектора = тип × 4 (). В защищённом режиме это дескрипторная таблица прерываний IDT, её базу и размер хранит IDTR. В ней 8-байтные шлюзы, адрес = тип × 8. Шлюз прерывания при входе снимает флаг IF, шлюз ловушки его не трогает, шлюз задачи переключает задачу ().
КПП 8259 собирает запросы от устройств на одну линию INT процессора (). Он фиксирует запросы IRQ0–IRQ7 в регистре IRR, маскирует их регистром IMR, выбирает самый приоритетный запрос с учётом уже обслуживаемых (ISR) и в ответ на INTA выдаёт на шину данных тип прерывания (). Каскад из ведущего и ведомого даёт 15 входов ().
APIC заменил 8259 в многопроцессорных системах: I/O APIC на плате принимает запросы устройств и рассылает их, Local APIC в каждом ядре принимает их, а также межпроцессорные прерывания, сигналы таймера, термодатчика и ошибок (). MSI обходится без линий: устройство PCIe записывает сообщение по адресу памяти, который на деле отображён на Local APIC ().
В микроконтроллере (для примера): у Cortex-M3 контроллер NVIC встроен в ядро, адрес вектора = номер × 4, а приоритеты делятся на группу и субприоритет. Весь путь прерывания от ножки до обработчика — в главе 01.
- Определение: изменение естественного порядка выполнения программы из-за внешних устройств, ошибок и особых ситуаций (). Классификация: аппаратные (маскируемые и немаскируемые, асинхронные) и программные, они же особые случаи: нарушения (рестарт той же команды), ловушки (продолжение со следующей), аварии (снятие программы) ().
- Обработка: прерывания распознаются на границах команд, тип 0–255; процессор определяет тип, сохраняет как минимум EIP, CS, EFLAGS, находит адрес обработчика и передаёт управление ().
- Таблица векторов (реальный режим): в младших адресах ОП, вектор 4 байта (IP и CS), адрес вектора = тип × 4 (). IDT (защищённый режим): как GDT, база и размер в IDTR, адрес = тип × 8, хранит только шлюзы: прерывания (снимает IF), ловушки (не снимает IF), задачи ().
- КПП 8259 (). Функции: принять и зафиксировать запросы IRQ0–IRQ7, маскировать, выбрать самый приоритетный, выдать на шину данных тип прерывания. Структура: IRR (запросы), IMR (маска), ISR (обслуживаемые), приоритетный арбитр, сигналы INT и INTA. Алгоритм: IRQ → бит в IRR → если не замаскирован, арбитр сравнивает с ISR → INT процессору → INTA → тип на шину, бит в ISR.порядок шагов не со слайда Каскад ведущий + ведомый даёт 15 входов ().
- APIC: Local APIC в каждом ядре + I/O APIC на плате, таблица перенаправления, межпроцессорная шина (). Источники для Local APIC: LINT0/LINT1, I/O APIC, межпроцессорные IPI, таймер APIC, термодатчик, внутренняя ошибка ().
- MSI: устройство не тянет линию IRQ, а записывает сообщение по определённому адресу памяти, который на деле отображён на Local APIC ().
- В МК (связь с задачами КР): исключения 1–15 системные, 16+ внешние (); меньше число — выше приоритет (); группа и субприоритет:
Прерываний в одной группе друг друга прерывать не могут.
() Адрес вектора = номер × 4 (); регистры NVIC (); вход в обработчик: 8 регистров в стек, выборка вектора, LR и PC (); EXTI ().
Не в списке тем КР: пригодятся на экзамене
История, защита, Meltdown и Spectre, кэш. На КР их, судя по официальному списку, не будет.
1История МП, поколения, от Intel 4004 до AMD64лекция 01
- Поколения ЭВМ: 1 — реле и лампы (пример — ЭВМ МИФИ), 2 — транзисторы, 3 — интегральные микросхемы, 4 — микропроцессоры ().
- Intel 4004, 1971, первый микропроцессор (). 8080, 1974, к нему схемы расширения: 8224 генератор, 8253 таймер, 8257 контроллер ПДП, 8259 контроллер прерываний ().
- 8086, 1978: РОН 16 бит, 8 РОН, больше режимов адресации и флагов, сегментный механизм: 1 Мбайт при 16-разрядных регистрах ().
- i286, 1982: реальный и защищённый режимы. В защищённом 24-битная шина адреса (16 Мбайт), до 1 Гбайт виртуальной памяти, защита по привилегиям. Реальный режим даёт 20 бит, 1 Мбайт, совместимость ().
- i386, 1985: первый 32-разрядный (IA-32), сегментно-страничная адресация, мультипрограммный режим, виртуальный режим ().
- i486, 1989: на кристалле кэш и блок плавающей точки, 5-ступенчатый конвейер (). Pentium, 1993: суперскалярность, раздельный кэш кода и данных, предсказание ветвлений ().
- Itanium, 2001: первый 64-битный Intel, IA-64 (). AMD64, 2003: Opteron и Athlon 64, полная обратная совместимость с x86. Аналог у Intel — Intel 64 (сначала IA-32e, потом EM64T) (). Athlon 64 X2, 2005: первый двухъядерный x86 для настольных ПК ().
Сначала поколения ЭВМ по элементной базе: лампы, транзисторы, интегральные схемы, микропроцессоры. Микропроцессор — четвёртое поколение, первый из них Intel 4004 (1971). Дальше история идёт как цепочка «что добавилось»: 8080 оброс отдельными микросхемами (таймер, ПДП, контроллер прерываний 8259), в 8086 появились 16-битные регистры и сегментная адресация на 1 Мбайт, в 286 — защищённый режим и привилегии, в 386 — 32 бита, страницы и многозадачность, в 486 на кристалл переехали кэш и FPU, Pentium стал суперскалярным. 64 бита пришли двумя путями: несовместимый Itanium (IA-64) и совместимый AMD64, который Intel затем повторил как Intel 64. Последний шаг на слайдах — два ядра на кристалле (Athlon 64 X2). Каждая из этих новинок — тема одного из следующих вопросов.
9Механизмы защиты, привилегии, шлюз вызовалекция 19
- Цели () и две группы средств: защита при управлении памятью и защита по привилегиям ().
- Защита при управлении памятью. Проверки при загрузке селектора: в DS/ES/FS/GS только сегмент с разрешённым чтением, в SS чтение и запись, в CS исполняемый, в LDTR только дескриптор LDT, в TR только TSS (). При обращении проверяется тип операции и выход за предел ().
- Кольца 0–3: 0 ядро ОС, 1 утилиты ОС, 2 служебные программы и драйверы, 3 приложения (). Поля: DPL в дескрипторе, RPL в селекторе, CPL = RPL селектора в CS, IOPL в EFLAGS ().
- Привилегированные команды (только CPL = 0): LGDT, LIDT, LLDT, LTR, LMSW, MOV CRn, MOV DRn, CLTS, HLT (). Ввод-вывод (IN, OUT, CLI, STI…) разрешён при CPL ≤ IOPL ().
- Данные: max(CPL, RPL) ≤ DPL (). Код при JMP/CALL без шлюза: в неподчинённый сегмент только при CPL = DPL, в подчинённый при CPL ≥ DPL, CPL при этом не меняется ().
- Шлюз вызова (call gate) нужен, чтобы вызвать код с реальным повышением привилегий. Дескриптор шлюза содержит селектор целевого сегмента (16) и смещение точки входа (32), P, DPL, WC (). CALL по селектору шлюза: шлюз → селектор и смещение → дескриптор целевого сегмента → база + смещение → точка входа (). Правила: max(CPL, RPL) ≤ DPLшл, DPLцс ≤ DPLшл, DPLцс ≤ CPL. Последнее не даёт запустить менее привилегированный код ().
- Защита страниц: биты U/S и R/W в ЭКТС и ЭТС, флаг CR0.WP. Сначала проверяются сегменты, потом страницы (). Расширенная модель колец −1 (гипервизор), −2 (SMM), −3 (ME) на .
Защита решает две задачи: не дать программе испортить чужие данные по ошибке и не дать сделать это намеренно. Поэтому средств две группы. Защита при управлении памятью ловит грубые ошибки: в сегментный регистр можно загрузить только подходящий по типу сегмент, а при каждом обращении проверяется, что смещение не вышло за предел и операция разрешена. Защита по привилегиям ловит тонкие нарушения. У программы есть текущий уровень CPL (0 — ядро, 3 — приложения), у сегмента — DPL, у селектора — RPL. К данным можно обратиться, если max(CPL, RPL) ≤ DPL. Привилегированные команды выполняются только при CPL = 0, ввод-вывод — при CPL ≤ IOPL. Прямо передать управление коду другого уровня нельзя. Для вызова более привилегированного кода (например, сервиса ОС) нужен шлюз вызова: дескриптор с фиксированной точкой входа, через который можно войти только «в разрешённую дверь». Поверх сегментов работает защита страниц битами U/S и R/W.
10Meltdown и Spectreлекция 22
- Атаки по побочным каналам. Условия: спекулятивное исполнение, TLB, ядро ОС отображено в адресное пространство процесса, для Spectre ещё динамическое предсказание переходов (). Почему важны таблицы страниц и TLB: .
- Meltdown (): (1) сбросить из кэша массив
userspace_array[256*4096]; (2) прочитать байт по адресу ядра. Исключение возникнет, но команды после чтения успеют выполниться спекулятивно; (3) прочитатьuserspace_array[tmp*4096], и эта строка попадёт в кэш; (4) измерить время доступа к 256 элементам. Быстрый элемент выдаёт значение секретного байта. Шаг 4096 выбран, чтобы каждое значение попадало в свою страницу и строку кэша.объяснение не со слайда - Spectre (): сначала обучить блок предсказания переходов, чтобы условие
x < array1_sizeпредсказывалось истинным. Затем подать x за границей так, чтобыarray1 + xуказывал на байт ядра. Спекулятивно выполнитсяarray2[array1[x] * 256], и секрет проявится через кэш так же, как в Meltdown. - В слайдах мало текста. Главное, что нужно объяснить своими словами: после отмены спекулятивных команд регистры откатываются, а состояние кэша нет. Через него и утекает информация.вывод не со слайда
Обе атаки — атаки по побочному каналу: секрет не читают напрямую, а узнают по времени доступа к памяти. Они возможны потому, что процессор выполняет команды спекулятивно (раньше, чем узнает, нужно ли), а ядро ОС отображено в адресное пространство процесса. Meltdown: программа читает байт ядра. Исключение возникнет, но следующая команда успеет спекулятивно выполниться и по значению байта загрузит в кэш одну из 256 страниц своего массива. После отката остаётся только след в кэше: замерив время доступа к 256 страницам, программа находит «быструю», её номер и есть секретный байт. Spectre делает то же без исключения: блок предсказания переходов обучают так, чтобы проверка границы массива предсказывалась как пройденная, и спекулятивно читается байт за границей.
12Кэш-память: типы, запись, когерентность, MESIлекция 18
Назначение. Кэш — небольшая быстрая память между процессором и ОЗУ, организованная как ассоциативное ЗУ. Она хранит то, что скорее всего скоро понадобится (). Работает это потому, что обращения обычно идут к соседним адресам, поэтому в кэш переносится сразу строка, а не отдельный байт (). Попадание даёт быстрый ответ, промах — медленный ответ из ОЗУ ().
Принцип. Строка хранится вместе с тегом — старшей частью адреса — и битом присутствия. Адрес запроса делится на тег и смещение, тег ищется среди тегов кэша, смещение выбирает байт в строке ().
Три типа различаются тем, куда можно положить строку. В полностью ассоциативном кэше — в любое место, поэтому тег сравнивается сразу со всеми строками. Память используется полностью, но схема дорогая и медленная (). В кэше с прямым отображением адрес делится на тег, индекс и смещение, и индекс задаёт единственную строку, где могут быть данные. Это быстро и дёшево, но две нужные строки с одинаковым индексом вытесняют друг друга, даже если рядом свободно (). Многоканальный кэш — компромисс: индекс выбирает набор из нескольких строк, и тег сравнивается только внутри набора (). Когда места нет, строку для вытеснения выбирают по LRU, LFU, FIFO или случайно (); с ростом объёма и числа каналов промахов меньше ().
Запись. При сквозной записи данные пишутся сразу в кэш и в ОЗУ: память всегда актуальна, но каждая запись медленная. При обратной записи меняется только кэш, а в ОЗУ строка попадает при вытеснении: без флага — всегда, с флагом изменения — только если её меняли ().
Когерентность. В многопроцессорной системе копии одного адреса в разных кэшах могут разойтись (). Протоколы бывают со справочником и с наблюдением за шиной. При записи другие копии либо аннулируются, либо обновляются (). В MESI каждая строка в одном из четырёх состояний: M — изменена, верна только здесь; E — только здесь и в ОЗУ; S — ещё и в других кэшах; I — недостоверна. Переходы происходят по своим чтениям и записям и по подслушанным на шине (). MOESI добавляет O: строка есть в нескольких кэшах, и этот кэш её владелец ().
Кэш i486: 4 канала, алгоритм PLRU, 128 наборов по строке 16 байт; адрес делится на тег [31:11], индекс [10:4], смещение [3:0] ().
- Определение: небольшая быстрая буферная память, организованная как ассоциативное ЗУ, для информации, которая скорее всего скоро понадобится (). Иерархия L1I/L1D, L2, L3, попадание и промах ().
- Ассоциативная адресация: хранятся пары тег + данные, поиск сравнением тегов, есть бит присутствия (). Хранятся строки, адрес делится на тег и смещение ().
- Три типа (). Полностью ассоциативная: тег сравнивается со всеми строками сразу; память используется полностью, но схема дорогая и медленная (). Прямое отображение: адрес = тег + индекс + смещение, индекс выбирает единственную строку; быстро и просто, но строки вытесняются при свободных соседних (). Многоканальная: индекс выбирает группу (набор), тег сравнивается со всеми строками группы ().
- Вытеснение: LRU, LFU, FIFO, Random (), таблица промахов (), псевдо-LRU ().
- Политика записи (): сквозная — сразу в кэш и в ОП, вытеснение без записи, но запись медленная (); обратная без флага — при вытеснении пишется всегда, лишние записи (); обратная с флагом (dirty) — пишется только изменённая строка ().
- Кэш i486: 4-канальный, PLRU, 128 наборов, строка 16 байт; адрес: тег [31:11], индекс [10:4], смещение [3:0] ().
- Когерентность (): протоколы со справочником и с наблюдением (snooping); запись с аннулированием и с обновлением. MESI: Modified, Exclusive, Shared, Invalid, плюс переходы по RH, WH, RMS, RME, WM, SHR, SHW (). MOESI добавляет Owned: строка есть здесь и ещё хотя бы в одном кэше, этот кэш её владелец (Owned) ().
- MESIF на только назван. Для ответа: это вариант Intel с состоянием F (Forward). Из нескольких копий в состоянии S одна помечена F и только она отвечает на запрос чтения, чтобы не отвечали все.не со слайда
06Где искать в RM0008 и PM0056 прямо на КР
В LMS даны ссылки именно на эти PDF. Номера страниц печатные, они совпадают с номером страницы в PDF (RM0008 Rev 21, PM0056 Rev 6). Быстрее всего искать через Ctrl+F по словам из столбца «искать». Регистры прерываний со всеми адресами одним списком: ЛР2 все регистры
| Что нужно | Документ, страница | Искать |
|---|---|---|
| Режимы GPIO: CNF/MODE, роль ODR для подтяжки | Table 20 | |
| CRL/CRH: какие биты у какой линии, сброс | GPIOx_CRL | |
| Аналоговый режим: IDR читается 0 | Analog configuration | |
| Номера IRQ и адреса векторов | Table 63 | |
| AFIO_EXTICR (какой порт на линии) | AFIO_EXTICR1 | |
| EXTI: IMR, RTSR, FTSR, PR | EXTI_RTSR | |
| RCC_CR, RCC_CFGR (PLL, HPRE, SW) | RCC_CFGR | |
| RCC_APB2ENR (IOPxEN, AFIOEN) | RCC_APB2ENR | |
| Такты ожидания флеша | wait state | |
| Порядок при равных приоритетах, вытеснение | 2.3.6 | |
| AIRCR и PRIGROUP, Table 45 | PRIGROUP | |
| IPR (только биты 7:4) | NVIC_IPRx | |
| ISER | NVIC_ISERx | |
| Приоритет SysTick (SHPR3) | SHPR3 | |
| Пределы PLL и HSE | (на КР его нет) | fPLL_OUT |
07План до пятницы
| День | Что делать |
|---|---|
| Вт, 20.10 | Прочитать главы 00 и 01 (прерывания), ответить на «Проверь себя». Решить задачу А на бумаге, сверить с главой 02 и прогоном по шагам. Вечером задача Б с нуля, не подглядывая, потом спойлер: отдельно проверить PRIGROUP и LATENCY. |
| Ср, 21.10 | Генератор задачи А: 4–5 вариантов, каждый сначала на бумаге, потом сверка с прогоном. Тренажёры главы 04: 15–20 литералов, 3–4 случайных варианта GPIO. |
| Чт, 22.10 | Теория по официальному списку: 7 (уже был на КР) и 6, 8, 13 по образцам, периферия STM32 по блокам, затем 2, 4, 5, 11 по абзацам «как рассказать». Один-два ответа написать своей рукой. Вопросы 1, 9, 10, 12 отложить до экзамена. |
| Пт, 23.10 | Утром пробежать ловушки задачи А, «Проверь себя» из главы 01 и таблицу главы 06. |